O filme acima tem 30,7 segundos. Para chegar a ele, preparamos imagens de três personagens digitais da MWS, reunimos referências das roupas, geramos vídeos com IA e escolhemos os trechos que entrariam na abertura do site.
O primeiro vídeo foi feito no Magnific. Os outros dois, no Comfy Cloud. Nos três, o modelo de geração de vídeo foi o Wan 3.0. Antes disso, usamos o ImageGen, dentro do Codex, para preparar as pranchas das personagens e algumas referências de produto. A montagem final foi executada com FFmpeg.
Este é o caminho que fizemos em setembro de 2026, com as imagens utilizadas, as instruções dadas aos modelos e os ajustes que o material exigiu.
1. Preparamos as personagens e separamos as referências das roupas
As três personagens do filme são Sayuri, Kiara e Kaori, do elenco digital da MWS. Cada uma precisava ser reconhecível em diferentes enquadramentos, enquanto as roupas exigiam referências próprias de frente, costas e detalhes.
Para organizar essas informações, trabalhamos com três tipos de entrada: imagens da personagem, imagens do produto e um vídeo de referência de movimento. O texto do prompt explicava como combinar tudo isso.
Sayuri: acertar a prancha antes de animar
A prancha de Sayuri foi preparada no ImageGen a partir de uma imagem já existente da personagem e de um esquema visual usado como referência de composição. O resultado reuniu três vistas: corpo de frente, sem a cabeça; corpo de costas; e um retrato ampliado do rosto.
Na primeira versão, a escala das vistas de frente e de costas precisava de ajuste. Fizemos uma segunda geração para aproximar as proporções. Essa versão, com roupa preta neutra, foi a que entrou no Magnific.
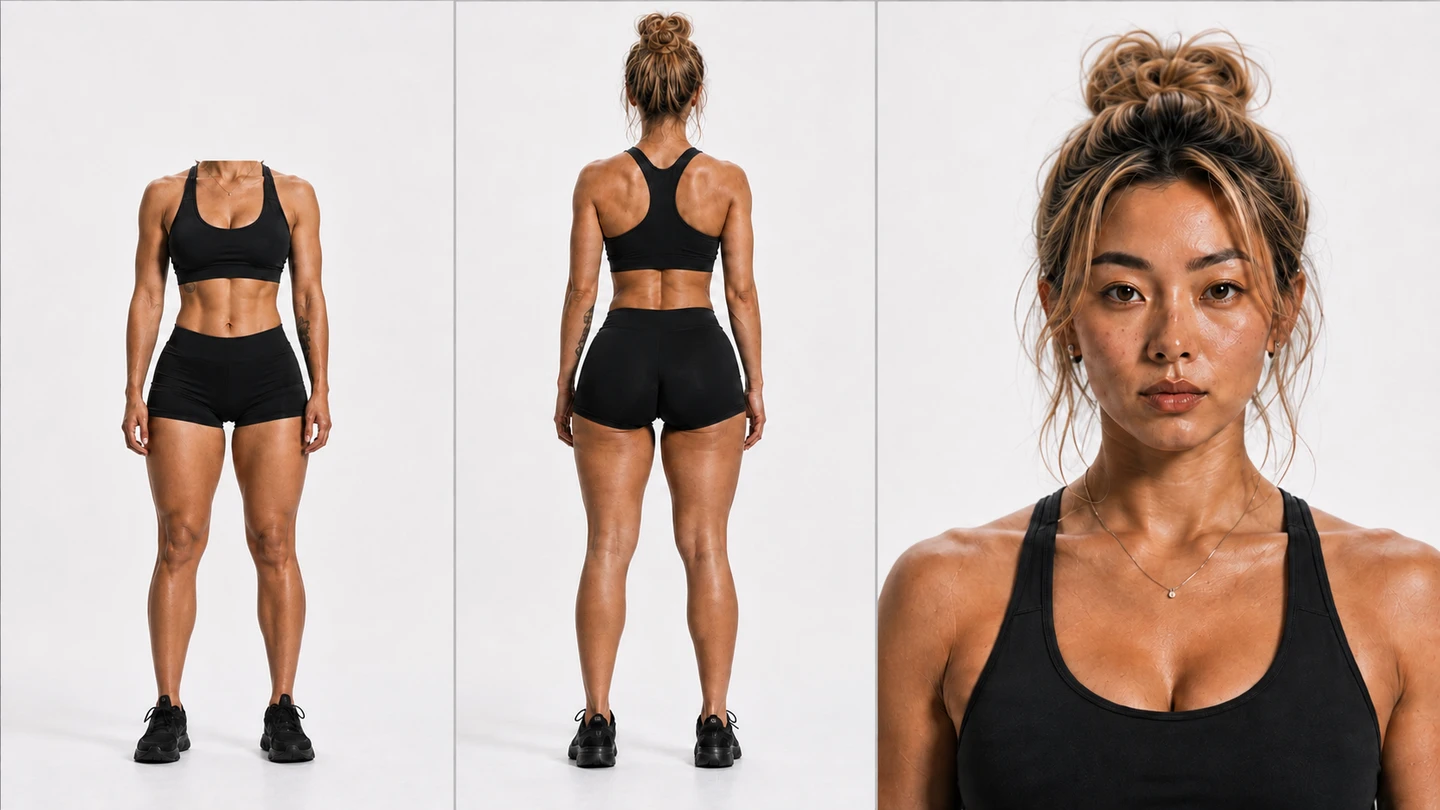
A referência real de Sayuri. A prancha define rosto, corpo, cabelo e aparência. A roupa do vídeo veio das imagens de produto abaixo.
Para vestir Sayuri com a jersey branca e o short preto, acrescentamos quatro imagens da jersey e duas do short. As diferentes vistas mostravam frente, costas, estampa e caimento.
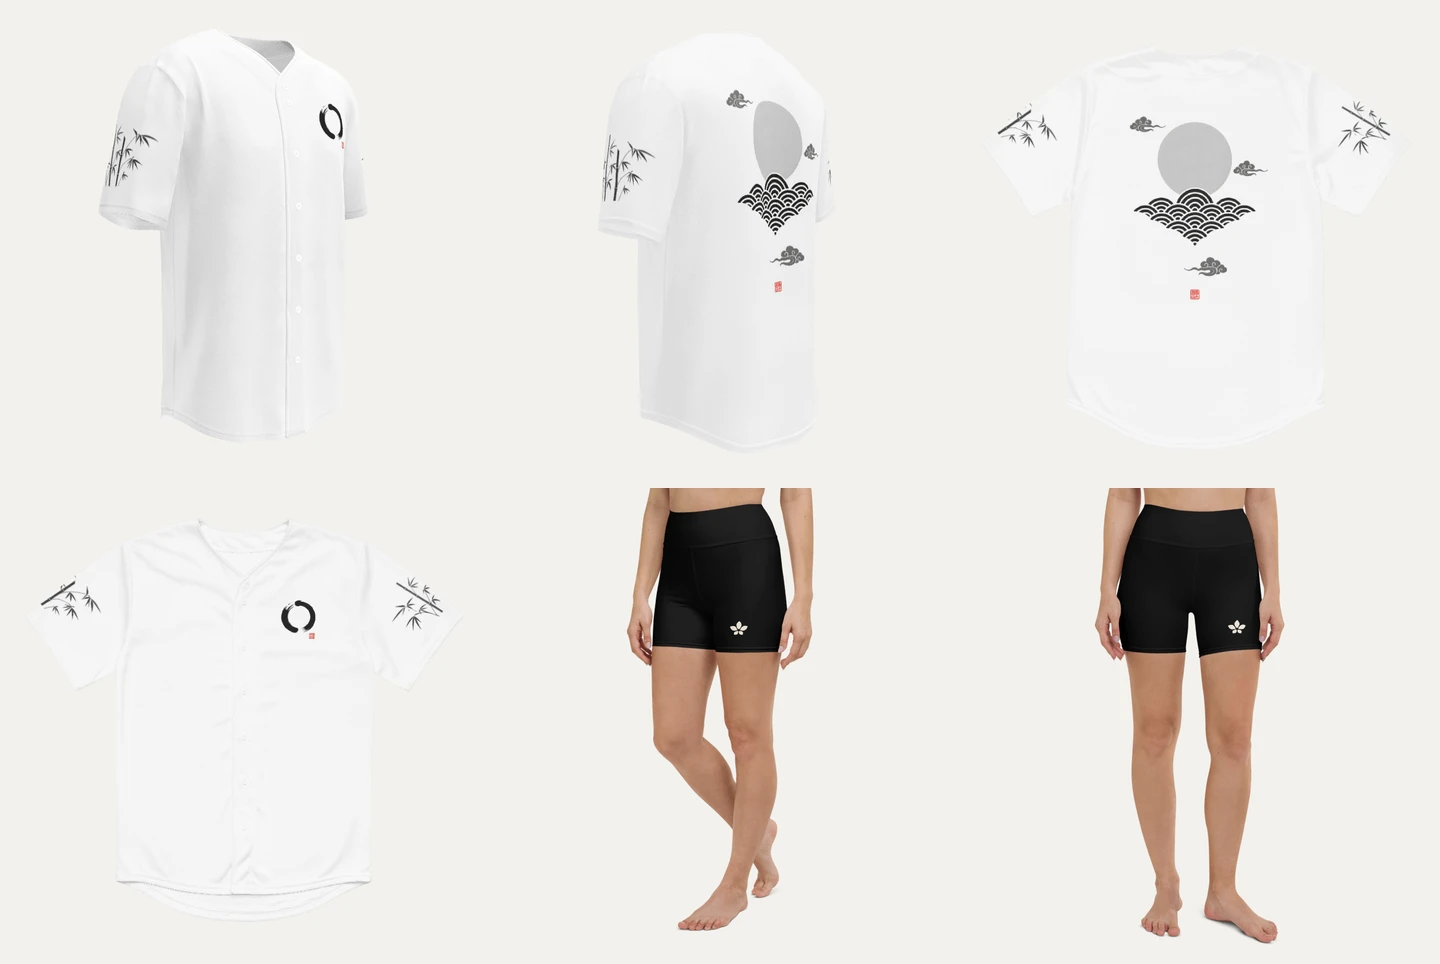
As seis imagens de produto enviadas ao Magnific. Na geração, elas foram entradas separadas; a prancha acima apenas as reúne para facilitar a leitura.
Essa separação tinha uma função prática: indicar quem deveria aparecer e, em outras imagens, o que ela deveria vestir. Ainda assim, como veríamos nos testes seguintes, fornecer boas referências não garante que a IA preserve todos os detalhes.
2. Geramos o primeiro vídeo no Magnific com Wan 3.0
Para a cena da academia clara, usamos sete imagens e um vídeo de movimento: a prancha de Sayuri, as seis imagens de roupa e um vídeo vertical de aproximadamente 14,5 segundos.
No Magnific, selecionamos Wan 3.0, duração de 15 segundos, proporção 16:9, resolução 1920 × 1080 e geração sem efeitos sonoros.
O prompt foi escrito em inglês e identificava cada referência. A primeira imagem correspondia à personagem; as quatro seguintes, à jersey; as duas últimas, ao short. O vídeo entrava como referência adicional de movimento.
Parte da direção, traduzida para o português, era:
Mostre-a realizando uma sequência curta de exercícios e poses: entrar caminhando, flexionar braços e costas, fazer agachamentos e avanços controlados e terminar em uma pose frontal olhando para a câmera. Combine planos médios e de corpo inteiro, movimentos laterais e aproximações para destacar a camisa e o short, em uma academia clara e moderna.
O ambiente iluminado, o movimento da câmera e a apresentação das roupas estavam descritos desde a geração. Esse clipe forneceu as imagens de Sayuri que aparecem na entrada do filme, nos detalhes da jersey, no agachamento e no retrato final.
Neste trabalho, o papel do Magnific foi gerar vídeo com Wan 3.0. A preparação das pranchas havia sido feita no ImageGen.
3. Testamos outro caminho antes de continuar com Wan
O processo também teve material descartado. Em um teste no Comfy, usamos Seedance 2.5 para tentar reunir quatro personagens em um vídeo de academia de 15 segundos, com exercícios diferentes. O resultado foi rejeitado. Kiara apareceu fazendo um movimento semelhante a crucifixo, embora o prompt pedisse remada baixa sentada.
As primeiras tentativas seguintes com Wan foram recusadas pela verificação de conteúdo do serviço, sem indicar qual entrada havia sido sinalizada. Testar cada personagem separadamente também não resolveu. Um teste posterior com Kiara e uma única referência de movimento produziu um vídeo.
Nos clipes que chegaram à montagem final, seguimos com Wan 3.0 e uma personagem por geração, mantendo vídeos de 15 segundos e referências específicas para cada uma.
4. Montamos o fluxo de Kiara no Comfy Cloud
Para Kiara, usamos novamente o ImageGen na preparação da prancha. Partimos de uma referência da própria personagem e adotamos a organização visual da prancha de Sayuri. Uma segunda versão retirou marcas da roupa de referência e ajustou a apresentação frontal e a textura da pele.
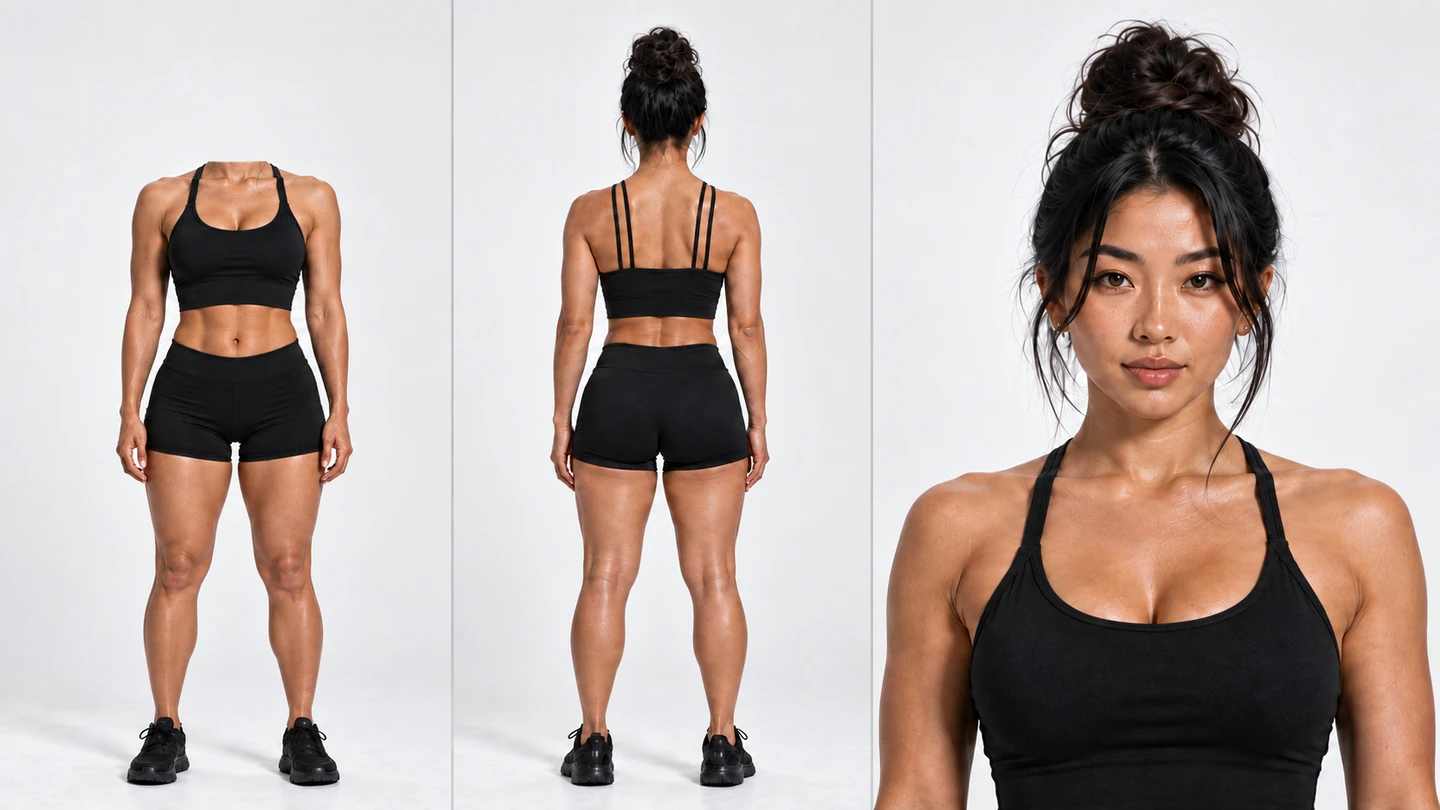
A prancha de Kiara enviada ao modelo. A organização se repete; a identidade é da própria personagem.
O vídeo tinha uma proposta diferente: academia escura, jersey preta na primeira metade e top na segunda. Reunimos oito imagens — uma prancha de Kiara, cinco vistas da jersey e duas do top — e um vídeo de movimento de aproximadamente 14,5 segundos.
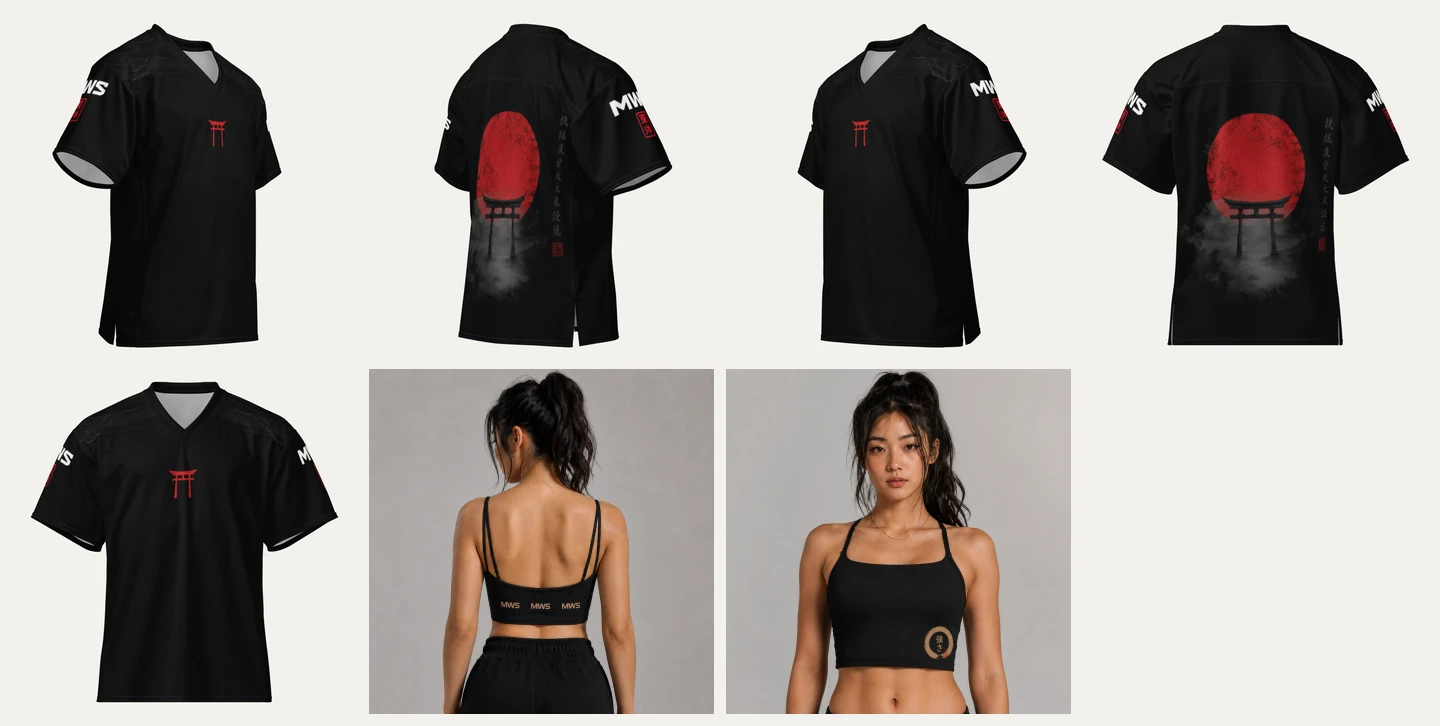
As referências de roupa de Kiara. A mudança de jersey para top foi pedida no mesmo vídeo de 15 segundos.
No Comfy, organizamos um fluxo visual: blocos carregavam as oito imagens e o vídeo de referência; todos alimentavam o bloco de geração Wan; um último bloco salvava o resultado. O modelo escolhido foi Wan 3.0 Reference to Video, identificado no fluxo como wan3.0-video.
A configuração foi de 15 segundos, Full HD, 16:9 e sem áudio. A expansão automática do prompt ficou desligada: usamos o texto que havíamos escrito, sem pedir ao serviço que o ampliasse.
O prompt dividia o tempo: jersey de 0 a 7,5 segundos; top de 7,5 a 15 segundos. Também pedia abertura em ângulo baixo, planos médios e de corpo inteiro, deslocamentos laterais, pequenos arcos de câmera e luz recortando o corpo no ambiente escuro. O encerramento deveria se aproximar do rosto.
Nessa versão, retiramos a lista de exercícios específicos do prompt. A direção ficou concentrada na apresentação da personagem, nas roupas, no movimento e na câmera.
5. Para Kaori, preparamos também o top em um manequim
A preparação de Kaori usou três novas imagens feitas no ImageGen: a prancha da personagem, a frente do top e as costas do top.
Na prancha, mantivemos o esquema de frente, costas e retrato, com atenção à textura natural da pele. Para o top, usamos um manequim branco, sem cabeça e sem braços, para apresentar a peça sem acrescentar outro rosto ou corpo humano à referência de identidade.
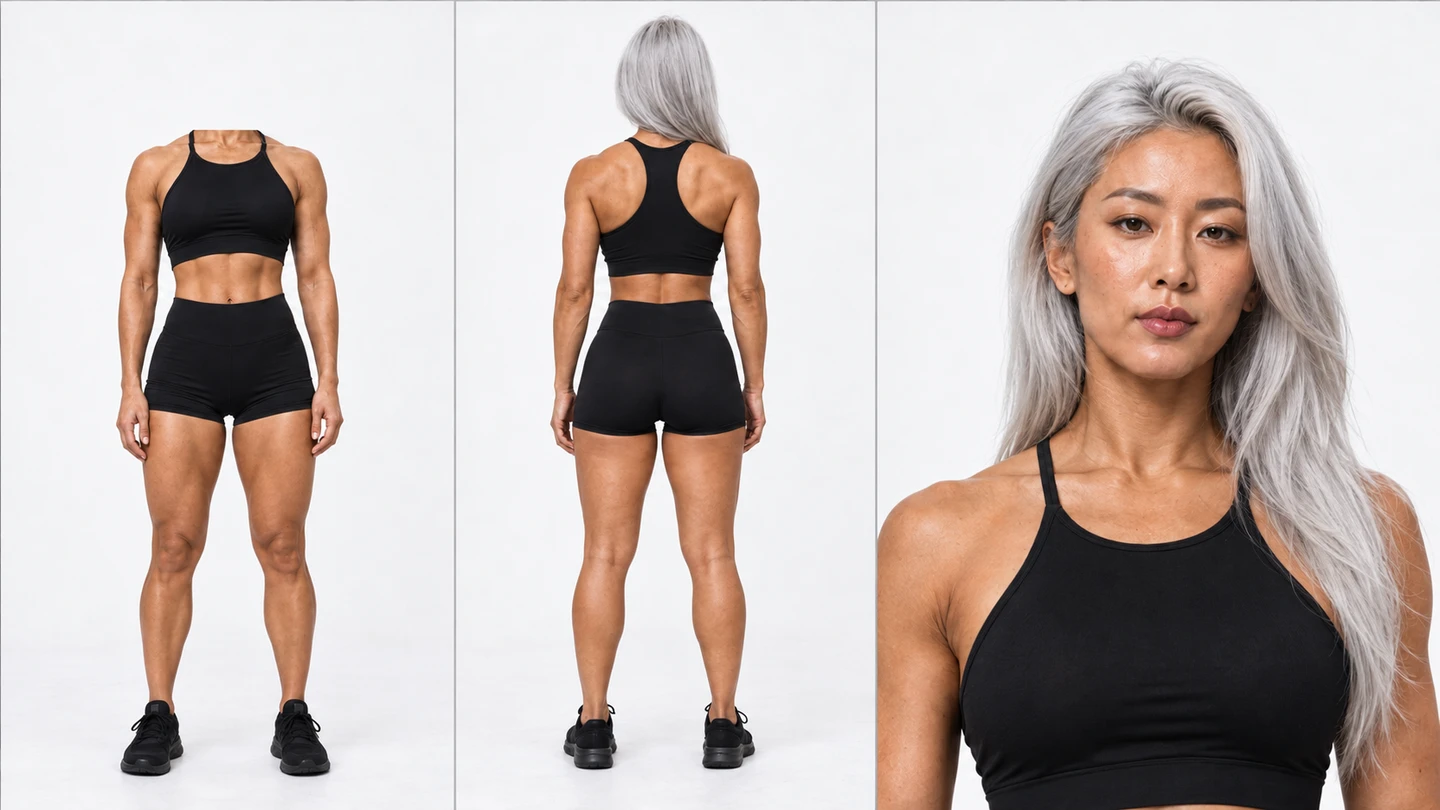
A referência de identidade de Kaori. As imagens do top e da legging entraram separadamente.
As costas do top exigiam atenção especial: o desenho das alças precisava ficar visível. Juntamos as duas vistas da peça a três imagens da legging. Com a prancha da personagem, eram seis imagens e um vídeo vertical de movimento, de aproximadamente 8,6 segundos.
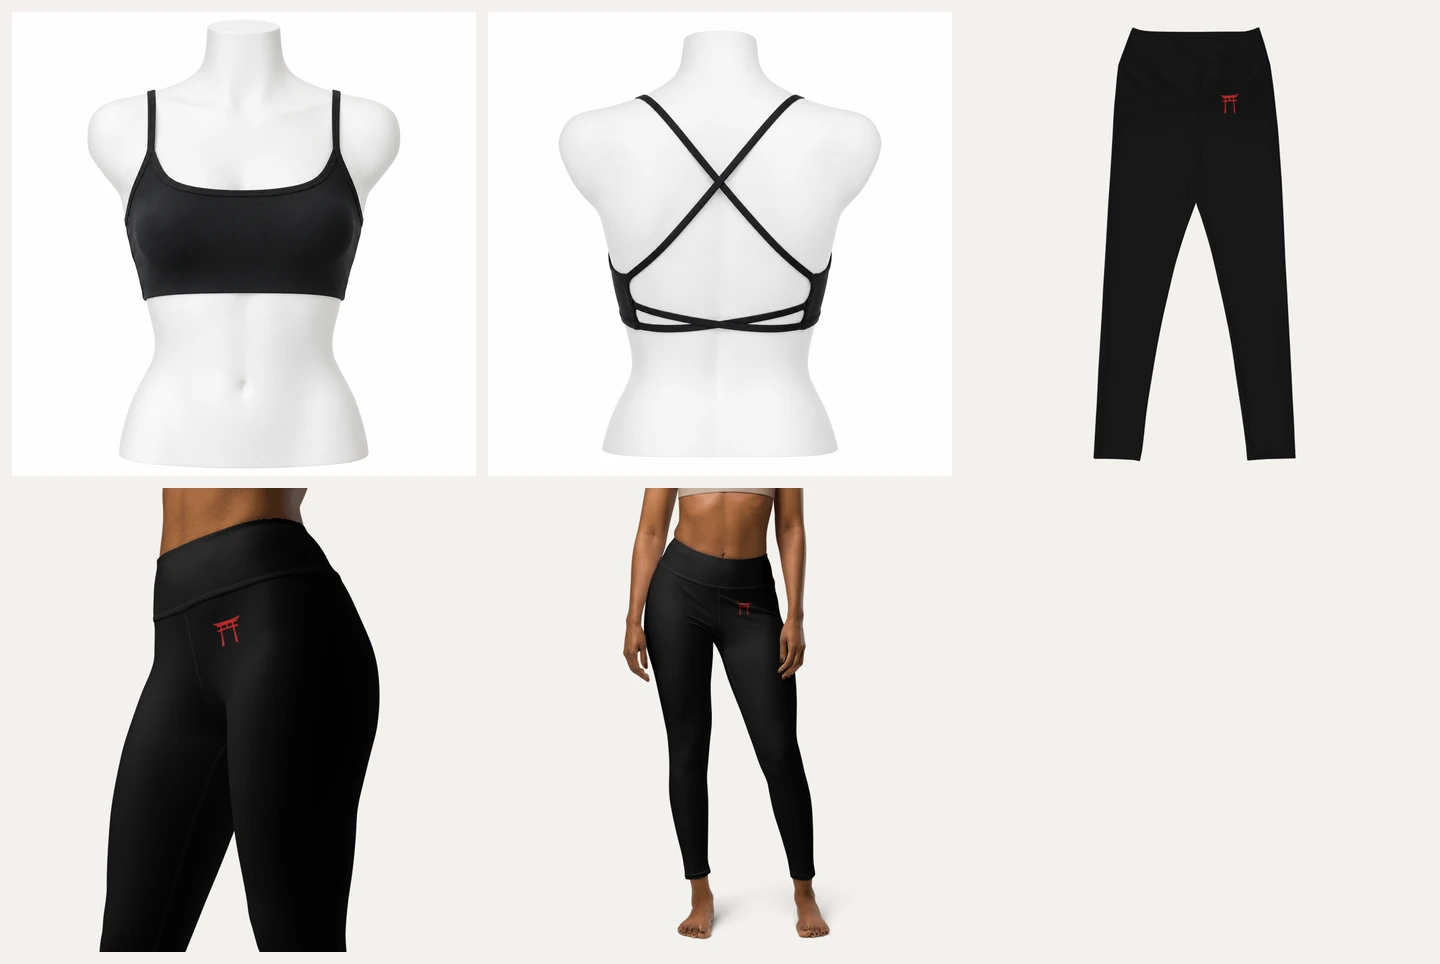
As cinco referências de produto de Kaori. O manequim ajuda a mostrar o recorte e as alças do top.
O vídeo voltou a usar Wan 3.0 no Comfy Cloud, com 15 segundos, Full HD, 16:9 e sem áudio. A direção pedia academia bem escura, iluminação lateral, planos de corpo inteiro e médios, vistas das alças nas costas, detalhes do tecido e da cintura e um close no encerramento.
Houve uma dificuldade operacional: o conector de upload disponível naquele momento não aceitava o arquivo MP4 da referência. Fizemos o envio pela API oficial do Comfy Cloud e ligamos o arquivo ao mesmo fluxo de geração. Assim, o modelo recebeu o vídeo de movimento junto das seis imagens.
6. Conferimos onde a geração acertou — e onde falhou
As referências orientaram os vídeos, mas o resultado não foi uma reprodução exata das peças em todos os quadros.
Em Kiara, a troca de jersey para top ocorreu perto dos 7,5 segundos solicitados. Na segunda metade, porém, apareceram variações no cabelo, no short e em elementos das estampas.
Em Kaori, o modelo mostrou short em parte do vídeo, apesar das referências de legging. O decote do top também se aproximou mais da roupa da prancha da personagem do que da peça enviada separadamente. Surgiu ainda um elemento vermelho na parte de trás da cintura que não estava nas referências.
Esses problemas não foram corrigidos pela montagem. A edição selecionou e organizou cenas; não redesenhou as roupas dentro delas. Para apresentar uma peça como imagem fiel de catálogo, essas diferenças exigiriam correção ou substituição dos planos afetados.
Esse foi um dos aprendizados concretos do trabalho: conferir o movimento e o rosto é apenas parte da revisão. Em um filme de moda, decote, alças, comprimento, estampa e caimento também precisam ser examinados.
7. Transformamos 45 segundos de material em um filme de 30,7 segundos
Com os três clipes de 15 segundos em mãos, fizemos a seleção dos trechos. A montagem foi executada com FFmpeg, seguindo uma lista de cortes e uma ordem definida para as cenas.
Organizamos o filme em 12 blocos, alternando Sayuri, Kiara e Kaori em quatro passagens. A sequência começa apresentando as personagens e os ambientes, passa por roupas e movimentos e termina nos retratos.
Os cortes precisaram de ajuste fino. Na primeira entrada de Kiara, por exemplo, um trecho inicialmente pensado para cerca de dois segundos foi encerrado em 1,6 segundo. Os quatro décimos seguintes já mostravam outro ângulo e criavam uma mudança muito rápida antes da próxima personagem.
Também reunimos o retrato e o close de Kaori no encerramento. Isso evitou interromper a aproximação do rosto para retomá-la depois.
Usamos cortes secos, mantendo velocidade, cores e enquadramento dos vídeos gerados. Não geramos cenas de ligação nem acrescentamos transições entre os clipes. O resultado ficou com 30,7 segundos, Full HD e 30 quadros por segundo, sem áudio.
8. Preparamos o arquivo para a abertura do site
A montagem foi aprovada em 9 de setembro e aplicada à versão de prévia do site. Nessa integração, preservamos o quadro horizontal completo e preparamos versões em 1080p para desktop e 720p para celular, além de uma imagem de apresentação para acompanhar o carregamento.
O vídeo foi configurado para reprodução automática, sem som e em repetição na abertura. A passagem do final para o início usa um corte seco; não criamos uma transição para esconder a volta.
O trabalho completo passou por ferramentas com funções diferentes:
| Ferramenta | O que fizemos com ela |
|---|---|
| ImageGen no Codex | Preparação e revisão das pranchas de personagem; frente e costas do top de Kaori em manequim. |
| Magnific + Wan 3.0 | Geração do vídeo de Sayuri na academia clara. |
| Comfy Cloud + Wan 3.0 | Organização das referências e geração dos vídeos de Kiara e Kaori. |
| Seedance 2.5 no Comfy | Teste com quatro personagens, descartado antes da montagem final. |
| FFmpeg | Seleção dos trechos, montagem dos 12 blocos e exportação dos arquivos. |
O filme que abre este artigo é o encontro dessas etapas: imagens preparadas, referências de produto, direção escrita, testes de geração e decisões de montagem. São essas escolhas — e a revisão do que a IA realmente entregou — que explicam como chegamos ao resultado.
Quer desenvolver um projeto audiovisual para a sua marca? Converse com a Mosaico sobre a ideia, os produtos e o que o filme precisa mostrar.